 К описанию модели
Как устроена наша модель
Проект
МФТИ × Positive Technologies
Данные
Сетевые взаимодействия LANL
Что делает модель
Описывает устройство по его сетевому поведению. По таким профилям можно искать похожие устройства, даже когда их реальные роли заранее неизвестны.
Читать об устройстве модели ↓
От незнакомого устройства — к понятному окружению.
Представьте: в сети появился компьютер, про который оператор почти ничего не знает. По адресу нельзя понять, зачем он нужен. Смотреть каждое соединение вручную долго, а отдельное обращение к серверу ещё не описывает его работу.
Мы хотим собрать эти события в профиль поведения. Он помогает ответить на более полезный вопрос: на какие устройства этот компьютер похож и что именно у них общего?
- Собираем окно активности. Берём записи соединений за выбранный промежуток. Важен набор событий, а не одно случайное обращение.
- Строим числовой профиль. Кодировщик описывает контакты, сервисы, объёмы и направления. Для известных устройств многодневная история дополняет короткое наблюдение.
- Ищем соседей. Сравниваем профили в одном пространстве. Близость означает сходство описанного поведения.
- Возвращаем контекст оператору. Список соседей полезно читать вместе с общими сервисами и характером обмена. Так можно проверить, чем вызвана близость.
Это сценарий использования продукта. На этой странице разобрана модель; вычисления по пользовательскому трафику здесь не запускаются. Проверенная многодневная версия работает с устройствами, известными на обучении.
Сначала — обычные соединения.
Хост — устройство в сети: например, компьютер или сервер. Сетевые записи показывают, с кем он общался, когда, по какому порту и сколько данных передал.
Мы используем записи LANL. Реальные роли устройств заранее не подписаны, поэтому модель ищет сходства в поведении.
- С кем
- Окружение и повторяющиеся контакты
- Как
- Сервисы, протоколы и направления
- Сколько
- Соединения, пакеты и байты
- Когда
- Активность за временное окно
Из записи — в привычку
Одно соединение описывает событие. Чтобы описать устройство, мы собираем множество событий за временное окно: повторяющиеся контакты, используемые сервисы, направления и объёмы обмена.
Два устройства могут регулярно пользоваться похожими сервисами, даже если их адреса различаются. Именно такие сходства полезнее сравнения самих имён и адресов.

Поведение переводим в числа.
Чтобы сравнивать устройства, нужен общий способ их описать. Кодировщик собирает сетевые признаки в один числовой профиль — вектор.
В базовом кодировщике объединяются поведенческие признаки, счётчики собеседников и сервисов, TF-IDF и две небольшие полносвязные нейросети. Вместе они дают 896 чисел.
Сетевые записи → Признаки + кодировщик → Профиль · 896
Что такое TF-IDF и MLP?
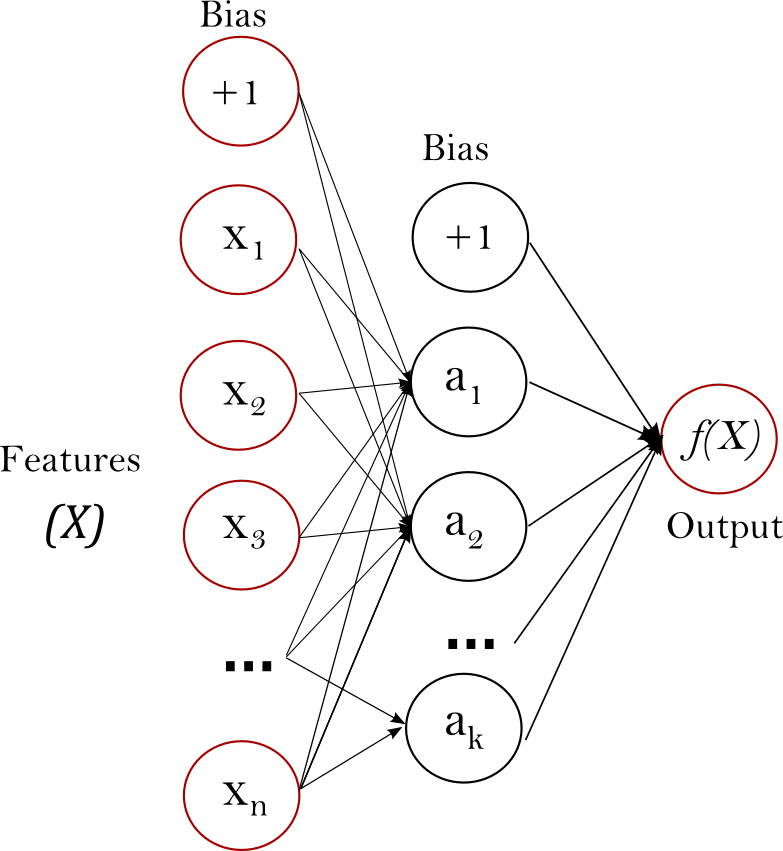
TF-IDF помогает учитывать характерные для устройства контакты и сервисы, снижая вес слишком распространённых. MLP — полносвязная нейросеть: несколько последовательных преобразований признаков. Поэтому базовый профиль сочетает разные способы описания поведения.

Что сохраняет каждая часть
Поведение: насколько активно устройство работает и как распределяется обмен. Это общий рисунок, который остаётся полезным даже при смене отдельных собеседников.
Контакты и сервисы: с кем устройство взаимодействует и какие виды обмена использует. Хешированные счётчики переводят большое количество категорий в представление фиксированного размера. Они экономят место, но не хранят названия категорий буквально.
TF-IDF: помогает отличать характерный контакт от очень распространённого. Сервис, к которому обращается почти вся сеть, обычно меньше помогает различать устройства, чем более специфическое окружение.
Две MLP-головы: добавляют обучаемые преобразования к подготовленным признакам. В карточке многодневной модели не опубликованы точные размеры их слоёв; схема выше поясняет общий принцип полносвязной сети.
Почему несколько способов описания
Общие счётчики передают интенсивность работы. Счётчики собеседников и сервисов добавляют окружение, а TF-IDF выделяет характерные контакты на фоне слишком распространённых. Нейронные головы дополняют эти признаки обучаемыми преобразованиями.
Поэтому базовые 896 чисел — составное представление. Нельзя считать, что весь профиль является выходом одной большой нейросети.
Как из чисел получается похожесть
Каждое устройство описано по одним и тем же правилам. После нормировки мы сравниваем направления векторов: близкие профили попадают выше в списке соседей. Это помогает найти устройства с похожим поведением, даже когда оператор ещё не знает их назначение.

После поиска соседей оператору нужен понятный контекст: общие сервисы, характерные контакты и время активности. Числовая близость подсказывает, куда посмотреть, а сетевые признаки помогают разобраться в причине.
Одного часа бывает мало.
Устройство может почти молчать или выполнять разовую задачу. Если смотреть только на такой фрагмент, получится неполная картина.
Поэтому для известных устройств мы обучаем отдельные многодневные профили. Каждый собирает сведения из истории, а не только из последнего часа.
История дней 03–12 → многодневный профиль
Начальный профиль берётся из кодировщика на дне 02. Затем он обучается по дням 03–12, сохраняя связь с прежними соседствами.

Почему короткое окно может обмануть
У компьютера может быть тихий час, ночная задача или разовая большая передача. Если сравнивать устройства только по этому фрагменту, временное событие легко принять за постоянную привычку.
История помогает отделить устойчивое окружение от случайной активности. При этом она не делает модель всезнающей: если поведение изменилось, старые связи могут уже хуже описывать настоящее.
Что именно обучается
Для каждого известного компьютера есть отдельный обучаемый вектор. Он начинается с профиля кодировщика на дне 02 и изменяется по истории дней 03–12. Цель — сделать похожие профили полезными для прогноза будущих собеседников.
Дополнительный штраф удерживает новое представление рядом с прежними соседствами. Это помогает не потерять структуру, которую уже нашёл кодировщик.
Параметры многодневной основы
В описании эксперимента указаны 400 шагов, вес штрафа соседства 1 и смесь адаптера 0,5. Итоговые настройки выбраны на дне 13. Обучаемые профили построены для когорты из 6453 известных компьютеров.
Три части. Один профиль.
В multiday_codebook_plus история дополняется двумя сигналами: будущими контактами и структурой сети. Получается 1024 числа.
| Блок | Размер | Зачем нужен |
|---|---|---|
| История | 896 | Устойчивый профиль известного устройства |
| Контакты | 64 | Сигнал о будущих новых собеседниках |
| Граф | 64 | Место устройства в структуре связей |
На диаграмме длина сегментов пропорциональна числу координат. Размер блока и его вес при сравнении — разные параметры.
Зачем нужны дополнительные блоки?
64 числа новых контактов учатся находить полезных соседей для прогноза будущих собеседников. Ещё 64 собственных вектора графа описывают структуру взаимодействий. Вес первого блока — 2, графового — 0,1. Настройки выбраны на дне 13.

Контакты и структура сети
Голова новых собеседников учится находить соседей, чьи контакты помогают предсказать будущее окружение исходного компьютера. Для неё используется штраф за отклонение от соседств основного профиля: вес штрафа 3, вес блока 2.
Графовый блок строится из 64 собственных векторов нормированной матрицы взаимодействий. Более свежие связи весят больше: полураспад составляет 3 дня. Вес самого блока — 0,1. В версии plus основная многодневная модель не переобучалась.
Важно не только сколько. Важно — с кем.
Два устройства могут передавать похожие объёмы, но находиться в разных частях инфраструктуры. Одно общается с небольшим набором общих сервисов, другое связывает несколько групп компьютеров. Граф добавляет сведения об этом окружении.

Что хранится в 64 координатах графа
Вершины графа — устройства когорты, связи — наблюдавшиеся взаимодействия. Из нормированной матрицы связей берутся 64 собственных вектора с наибольшими по модулю собственными значениями. Они компактно передают часть структуры сети.
Это математическое представление окружения. Каждая координата не является готовой меткой вроде «бухгалтерия» или «сервер»: таких подписей в исходных данных нет.
Почему новые собеседники — отдельная голова
Граф описывает известную структуру, а голова New partners учится подбирать соседей, чьи контакты полезны для прогноза будущего окружения. Эти сигналы связаны, но решают разные задачи.

При обучении используются будущие собеседники из дней 03–12, а не из закрытого теста. Дополнительный штраф с весом 3 удерживает голову рядом с соседствами основной модели. После обучения блок получает вес 2 при сборке профиля.
А если пришли новые записи?
История устройства и его сегодняшняя активность должны быть описаны на одном языке. Для этого используется адаптер Ridge — обучаемое линейное преобразование.
Он переводит профиль свежего окна в пространство многодневных профилей. Два дополнительных блока получаются из взвешенного среднего 20 ближайших обучающих профилей.
Свежее окно → Адаптер → Общий профиль
Это не обучение заново при каждом запросе. Адаптер обучается заранее. Профили исследованной версии рассчитаны для устройств, известных на обучении.
Ridge в официальной документации scikit-learn ↗

Как выбираются подсказки из истории
Для позднего окна находим 20 ближайших профилей источника. Их дополнительные блоки усредняются с весами softmax; температура 0,02 усиливает вклад самых близких. Основные 896 чисел при этом получаются через Ridge, а не из этого усреднения.
При обучении адаптера свежие дни имеют больший вес: через 3 дня вес наблюдения уменьшается вдвое. Так преобразование учитывает более актуальное поведение.

Учимся на прошлом. Проверяем на будущем.
Готовых подписей ролей нет. Вместо этого используем задачи, ответы на которые можно получить из самих записей: узнать устройство в другой день, предсказать связь и найти нового собеседника.
| Дни | Этап |
|---|---|
| 02–12 | Обучение |
| 13 | Выбор настроек |
| 14–16 | Финальная проверка |
Базовый кодировщик учится по 32 часовым окнам из дней 02–09. История, контакты и граф используют обучающие дни. Тестовые окна не участвуют в выборе настроек.
Многодневная модель использует больше истории, чем исходные подходы. Часть прироста качества может объясняться именно этим.

Что входит в каждый этап
- Кодировщик: 32 часовых окна — часы 10–13 дней 02–09.
- История: профили известных устройств по дням 03–12.
- Plus: голова контактов и граф используют связи только дней 02–12.
- Оценка: на днях 14, 15 и 16 берётся окно 12:30–13:30.
В таблице методы сравниваются на общей группе из 1581 компьютера. Это группа оценки; её размер отличается от обучающей когорты многодневной модели.
Как изменилось качество.
Общий балл объединяет несколько задач и позволяет сравнивать подходы. Это не процент обнаруженных атак.

| Модель | Балл |
|---|---|
| Временной кодировщик | 56,5 |
| Многодневная история | 64,9 |
| История + контакты + граф | 70,0 |
Интервал оценки последней модели: 65,6–73,4. Это не процент обнаруженных атак.
- 59,6%
- Узнать то же устройствоIdentity Top-1: верное устройство первым в списке кандидатов.
- 0,974
- Предсказать связьROC-AUC: качество ранжирования пар со связью и без неё.
- 0,318
- Найти нового собеседникаMRR: чем выше верный контакт в списке, тем лучше.

Какие задачи стоят за общим баллом
Итог объединяет поведение, будущие связи, общих собеседников и узнавание устройства. Используется среднее геометрическое четырёх задач: сильный результат в одной из них не должен полностью скрывать провал в другой.

Многодневная история сильнее улучшает узнавание устройства: Top-1 растёт с 0,373 до 0,594. В plus этот показатель меняется до 0,596, а MRR новых контактов — с 0,250 до 0,318. При этом Neighbors@10 снижается с 0,222 до 0,208.
Ни один из этих показателей сам по себе не означает точность определения ролей или обнаружения атак. Общий балл и прирост каждой отдельной задачи нужно читать раздельно.
Как читать результаты без ML-терминов.
Одна высокая цифра не описывает все свойства модели. Поэтому мы задаём несколько разных вопросов и смотрим, где представление оказалось полезным.
- Neighbors@10
- Похожи ли соседи по поведению? Смотрим, насколько устройства с близкими профилями действительно похожи в сетевом поведении. Это проверка соседства, а не точность определения должности компьютера.
- Links · AUC
- Можно ли отличить будущую связь? Проверяем, насколько хорошо модель ставит пары со связью выше пар без неё. AUC 0,974 не означает «97,4% найденных атак» или «97,4% всех соединений угаданы».
- Partners · MRR
- Насколько высоко стоит верный новый контакт? Важна позиция подходящего собеседника в списке кандидатов: чем ближе к началу, тем лучше. Показатель 0,318 не является процентом правильных ответов.
- Pairs · AUC
- Рядом ли устройства с общими собеседниками? Проверяется, сохраняет ли профиль сходство окружения. У версии plus этот показатель равен 0,992 по таблице проекта.
- Identity · Top-1
- Узнаём ли тот же компьютер в другой день? Правильное устройство должно оказаться первым среди кандидатов. Результат plus — 0,596, или 59,6% таких ответов в данном протоколе.

Почему балл 70 не равен «точности 70%»
Сначала результаты переводятся в сопоставимую шкалу. Затем колонки объединяются в четыре задачи: поведение, будущие связи, общие собеседники и узнавание. Итог — их среднее геометрическое.
У шкалы похожести поведения есть особенность: за идеал берётся уровень поведенческого представления, а не число 1. Это позволяет учитывать, что поведение в будущем окне само меняется.
С чем мы сравнивали
В проекте есть простые поведенческие признаки, гибриды с TF-IDF, временные кодировщики, автоэнкодеры и графовые подходы. На диаграмме показаны все 17 методов, участвующих в рейтинге. Случайные векторы и служебные ориентиры в него не включены.

Сильная сторона текущей версии — сочетание устойчивого профиля и дополнительных сигналов связей. Ограничение сравнения — разный объём истории. Чтобы отделить пользу архитектуры от пользы данных, нужен отдельный эксперимент с одинаковым обучающим периодом.
Что ещё нужно проверить.
Похожее поведение не доказывает одинаковое назначение. Без разметки ролей мы не можем заявлять точность определения «серверов» и «рабочих станций».
Рост общего балла также не означает улучшение каждой задачи: Neighbors@10 у plus снизился с 0,222 до 0,208. Полезность соседей, групп и объяснений нужно оценивать вместе с оператором.
Техническое описание и исходные результаты
Новый компьютер — отдельная задача
Обучаемые профили рассчитаны для устройств, известных на обучении. Хороший результат узнавания этой когорты не доказывает такое же качество для полностью нового устройства. Это нужно проверять отдельно.
Как проверить пользу для вашей команды
Начните с небольшого представительного фрагмента сети. В лаборатории можно пройти путь оператора: выбрать устройство, найти похожие, проверить реальные контакты и сравнить два периода.
- Собрать контекст. Выберите записи обмена или готовые профили. Сохраняйте одинаковые правила подготовки признаков, когда сравниваете периоды.
- Оценить соседей вместе с оператором. Помогают ли найденные устройства разобраться в поведении? Какие общие контакты и сервисы объясняют их близость?
- Проверить рабочий сценарий. Сравните полученный контекст с тем, что специалист уже видит в журналах. Для пилота важна полезность в разборе конкретных устройств, а не одна красивая цифра.
Посмотреть сравнение двух периодов в лаборатории ↗
Что показывают иллюстрации
Схемы на странице объясняют состав и путь данных. Графики результатов построены по таблице репозитория. Они не являются живым измерением корпоративной сети и не запускают обучение в браузере.